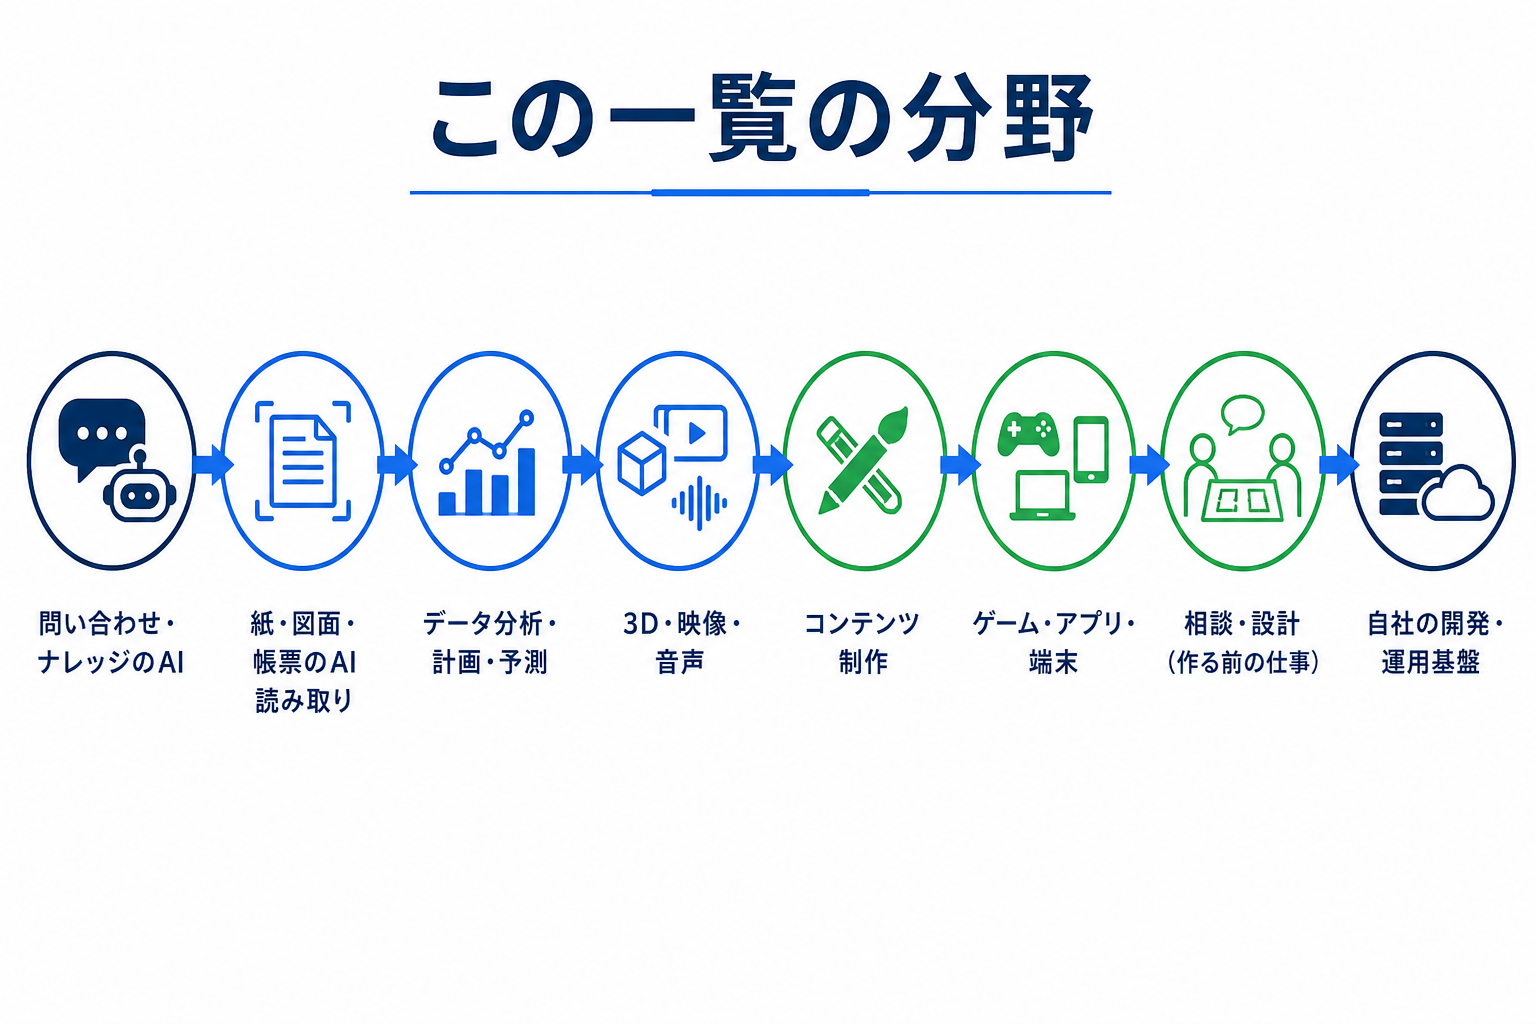
作ったもの・動いているもの・提案したものの一覧(随時追加) 分野ごとに並べています。できることは増えていくので、随時足しています。 項目をクリックすると、どういうものか・どう作るかが開きます。
電話・メール・チャットで来る質問に、社内の知識を根拠にして答える仕組みです。窓口が違っても同じ知識を参照する構成にできます。
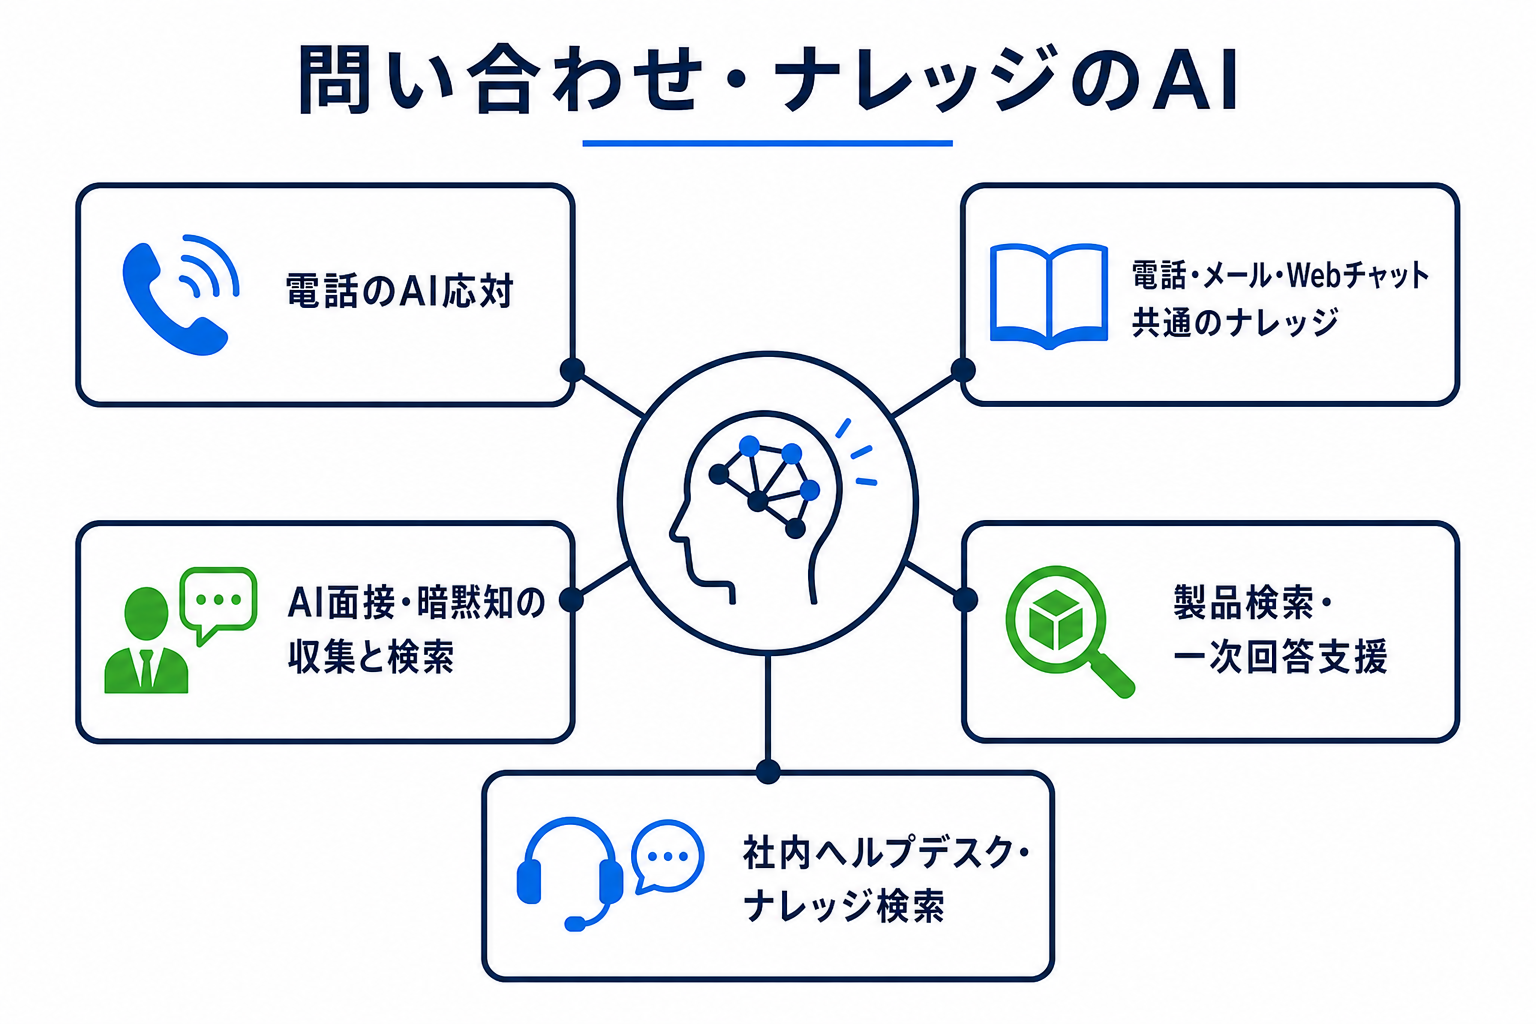
電話の一次受付をAIが担います。かかってきた電話に出て用件を聞き、答えられるものはその場で答え、人に代わる必要があるものは担当者へつないで会話を引き継ぎます。こちらから架ける使い方や、音声メニューの番号で用件ごとに振り分ける使い方もできます。
Twilio の電話回線から音声をそのままリアルタイム音声AI(OpenAI Realtime API)へ中継し、聞き取り・応答文の生成・読み上げを一つのモデルで行う構成です。AIが会話の途中で社内ナレッジの検索・担当者への転送・通話の終了を自分で呼び出せるようにしてあり、実際の電話回線に架電して動作を確かめています。
電話・メール・Webチャットのどの窓口から聞かれても、同じ社内の知識を根拠にして同じ答えを返します。窓口ごとに別のFAQを作って内容がずれる、という状態をなくせます。画面では3つの窓口に同じ質問を同時に投げて、答えが揃うことをその場で確かめられます。
社内文書をベクトルDB(Qdrant)に入れ、意味での検索とキーワード検索を両方走らせて結果を統合(RRF)し、見つかった文章だけを根拠に回答を作ります。1万件を登録した規模検証では、検索時間の中央値は12.8ミリ秒でした。
辞めてしまうと失われるベテランの判断を、AIが聞き手になってインタビューし、文字起こしして検索できる知識にします。「なぜそう決めたのか」「どの代替案を捨てたのか」まで残すので、後から読んだ人が同じ判断を再現できます。2社のお客様の業務で実際に使われています。
画面上のアバターとリアルタイム音声AIが対話して音声を取り、文字起こししたうえでベクトルDBに蓄積します。回答するときは先に検索して、出典として使う記録を人が選んでから答えを作る順番にしています。
取扱説明書や仕様書をまとめて読み込ませ、品番や症状を伝えるだけで該当箇所を引き当て、お客様へ返す一次回答の下書きまで作ります。どの資料の何ページに書いてあるかが一緒に出るので、回答者が根拠を確かめてから出せます。重複を除いた取扱説明書226冊を取り込んだ状態で動いています。
PDFをページ単位に分けて索引を作り、キーワード検索(BM25)と意味での検索を統合(RRF)して根拠ページを絞り、そのページを文字と画像の両方でLLMに渡して回答させます。品番の全角・半角・ハイフン・世代違いといった表記の揺れは、正規化と編集距離で寄せています。
情シスや総務に毎日来る「あの申請はどこか」「このエラーはどうするか」を、社内文書を根拠にAIが一次回答する仕組みです。担当者は例外だけを見るようになり、答えた内容がFAQとして溜まっていきます。現在は提案・設計の段階です。
既存のファイル共有やグループウェアから文書を定期取得して索引を作り、意味検索とキーワード検索を併用したうえで、閲覧権限で絞って出典つきに答える構成です。問い合わせ対応の部分は、同じ作り方の公開デモで実際に触って確かめられます。
スキャンした紙やPDFの図面から、文字や構造を取り出して業務に使える形にします。OCR単体でもLLM丸投げでもない組み方をしています。
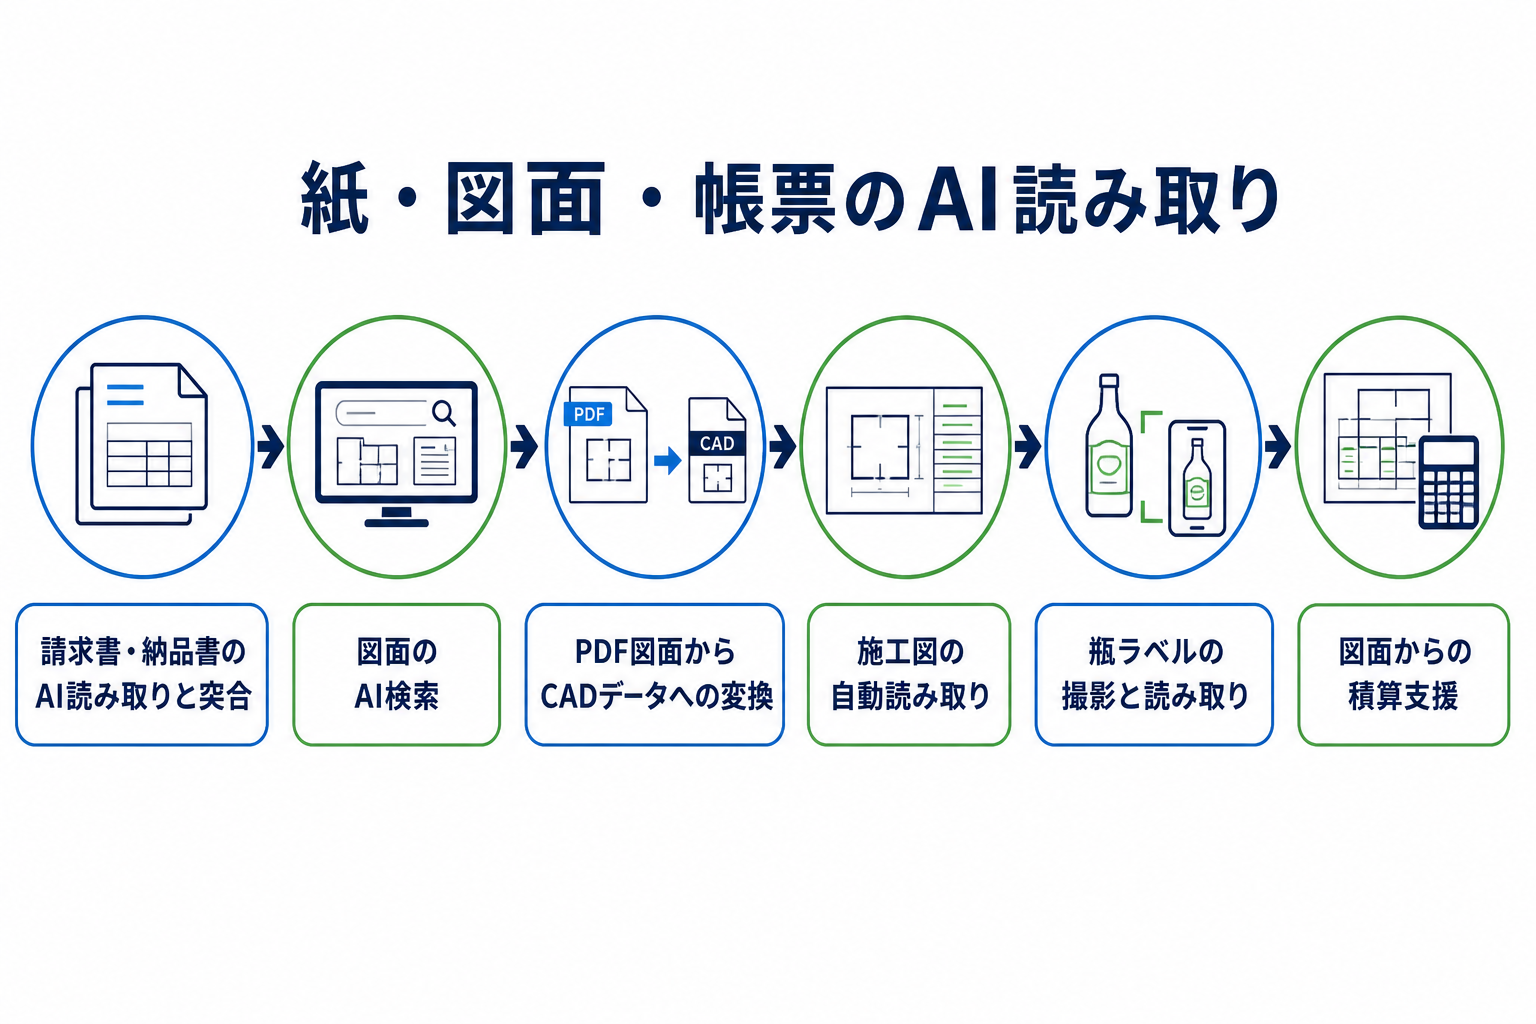
紙やPDFの請求書・納品書を読み取り、自社の発注データや契約台帳と突き合わせて、合っていないところだけを色で示します。人は全件を目で追う代わりに、指摘された例外だけを確認します。商談でその場で触っていただける動くデモがあります。
帳票の画像をLLMの画像読み取りで項目ごとに取り出し、台帳と「取引先+品目」で突合して、金額の不一致と形式エラーを分けて表示します。検証では1枚あたり2.8〜5.3秒で読み取れました(受入基準は30秒以内)。
過去の図面を、ファイル名ではなく中身で探せるようにします。管の種類や口径、年度などの条件でも、文章での言い回しでも引けるので、「前に似た工事をやったはず」を人の記憶に頼らず辿れます。ブラウザ上で図面を開いて数量を拾ったり、基準に合っているかを確かめたりもできます。
図面ファイルから文字と属性を取り出して台帳と全文索引を作り、意味での検索用にベクトルも持たせます。実データでの検証では管種と口径の検出率が100%、工事対象の判別はレイヤー名と色を併用して100%まで上がりました(文字だけでは11%)。
スキャンしただけの図面や画像のPDFから、CADで編集できるDXFを作ります。壁・寸法線・記号などが別々のレイヤーに分かれて出てくるので、受け取った側がそのまま作図を続けられます。
決まった形を正確に拾う部分は画像処理(OpenCVの直線検出)で、図面の意味を読む部分はLLMの画像読み取りで分担し、どちらも ezdxf でレイヤー付きDXFに書き出します。値の出どころ(読み取り/推定/計算)を区別して画面に出す作りにしています。
施工図を読み取って、部材の符号・寸法・数量・仕様を発注書の形の一覧表にします。表の行をクリックすると図面の該当箇所が光るので、合っているかをその場で確かめられます。
図面PDFを高解像度で画像化し、座標つきで文字を拾うOCR(Google Cloud Vision)とLLMの画像読み取りを組み合わせ、品番の形式ルールで集計品番に当てます。原本13ページを伏せた状態で読ませた検証では姿図の項目を100%取れ、解像度を150dpiから300dpiへ上げると高さ寸法の取りこぼしが解消しました(5/7→7/7)。
容器を回しながら自動で撮影し、ラベルの品番・内容量・ロット・保管温度などを読み取って検品の記録を作ります。手で持ち替えて何枚も撮る作業がなくなります。撮影する台も自分たちで作ったので、容器の大きさや撮影条件に合わせて直せます。
小型マイコン(Raspberry Pi Pico)でステッピングモーターを回し、スマートフォンのカメラで1周分を撮って円筒の展開図に起こし、文字は写真を外部へ送らずに端末内で完結するOCR(Apple Vision)で読みます。ルールで埋まらなかった項目だけ文字情報をLLMに渡す作りで、検証では1本あたり平均20秒、24本のサンプルで品番は24/24読めました。
図面や集計表から数量を拾い、積算の下書きを作ります。人がやると見落としや数え違いが出るところを機械が全セル走査し、読めなかった箇所は「判読不能」と名指しして人に回します。実際の図面をお預かりすれば、どこまで読めるかを先に確かめてからお見せできます。
表の罫線から格子を機械的に確定し、セルごとに書き込みの有無を画素で判定して空欄を除き、残った行だけを回転・拡大してLLMに読ませる構成です。実図面での検証では罫線から4,182セルを確定し、うち約52%が空欄であること、PDFには文字情報が0文字しか入っていないことまで実測しました。
Excelや基幹システムにあるデータを、計画や判断に使える形にします。根拠が見える形にすることを重視しています。
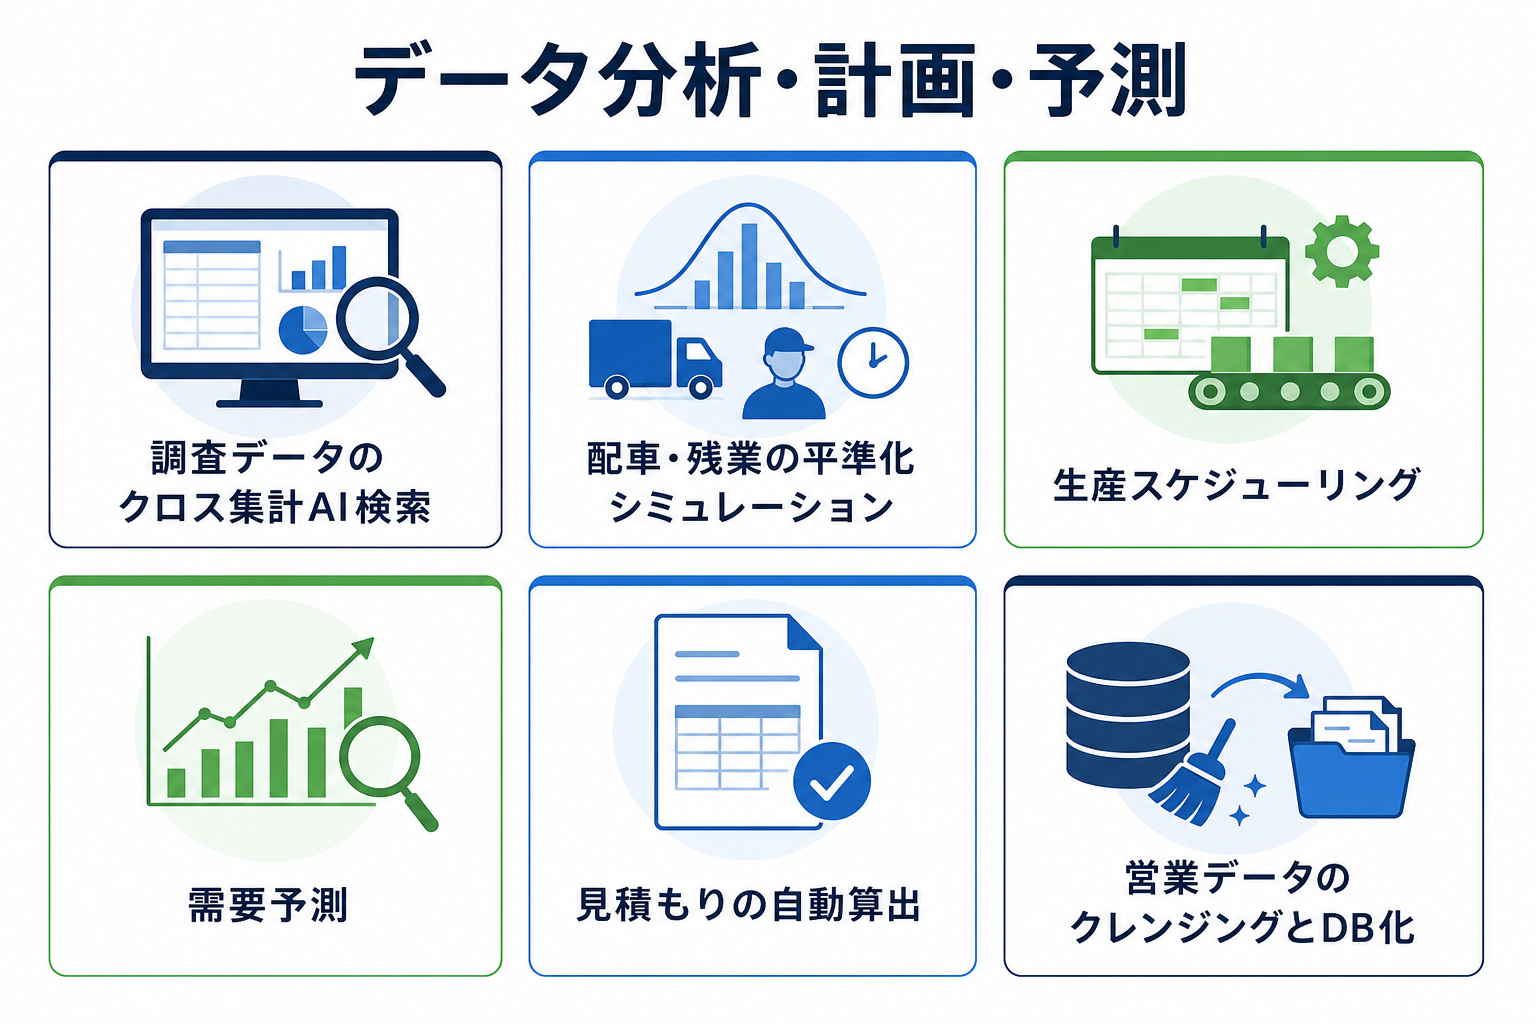
「この設問を年代別に見せて」のような言葉で聞くだけで、長年の調査データをクロス集計した表とグラフが出てきます。どの調査年・どの設問・どの軸を使ったかが一緒に出るので、数字の出どころを確かめられます。選べない組み合わせは最初から選択肢に出さないため、押したら空振り、ということが起きません。
LLMには「年・設問・軸・区分」をカタログの中から選ばせるだけにして、数値そのものはデータベースから取り出す分担にしています。150万件を超える集計値を持つデータベースと、年×設問×軸の全組み合わせを機械で検査する仕組みを合わせています。
過去の配車実績を読み込んで、「このやり方なら誰の残業がどれだけ減るか」を数字で見せます。担当の入れ替え、短時間勤務者の投入、応援の出し方といった複数の打ち手を、同じ土台で比べられます。実績データを入れ替えれば、そのまま自社の条件で試せます。
事業所ごとに様式が違うExcelを読み取ってデータベースに揃え、担当替えの平準化は数理最適化(Google OR-Tools の CP-SAT)で解きます。公開して見せる版は、実名や取引先名が混ざっていないことを機械で検査してから出す作りにしています。
生産計画と過去の実績から、どの機械でいつ何を作るかの計画表を自動で作ります。所要時間を勘ではなく過去の実績から出すので、納期に間に合わない案件がどれかを先に把握できます。ブラウザのガントチャートで見ながら、言葉で指示して直せます。
同じ図番・同じ機械の過去実績から1個あたりの時間を割り出して所要時間を推定し、納期超過を減らす割り付けを数理最適化(CP-SAT)で解いてガントチャートに描きます。数万行規模の実績データを取り込んだ状態で動かしています。
受発注や仕入れの実績から先の需要を見積もり、「いくつ発注するか」の判断材料を作ります。AIが数字を推すところまでで、決めるのは人という形にします。どのくらい当たるかは扱う商材で変わるので、短い期間で実測してからご判断いただけます。
基幹システムから実績を抜き出し、過去データで答え合わせ(バックテスト)して精度を数字で示したうえで、AIの推奨値を人が承認する画面を置く構成です。精度そのものは約束せず、必ず実測した数字をお見せしてから進めます。
料金表と過去の見積もり実績を突き合わせて、見積書のたたき台を作ります。担当者は金額の調整と最終判断だけを行います。業者ごとに書式が違う見積書を取り込んで、比較できる一枚の表にする使い方もあります。
PDFやCSVから明細を取り出し、品目名をベクトル化して過去の分類実績(PostgreSQL + pgvector)に寄せて自動分類し、担当者の修正がそのまま学習データに戻る作りです。問い合わせの文面から条件を抜き出し、足りない項目は確認メールの下書きを自動で作る試作もあります。
部署や担当者ごとにバラバラになったExcelを、検索できるデータベースに揃えます。Excelを捨てる必要はなく、入力や閲覧の慣れたやり方は残したまま、集計と検索だけが効くようになります。お預かりした実データで最後まで通し、結果を報告書の形でお返ししています。
表の位置から機械的に拾える部分は自前の処理で取り、位置では判別できない品名と仕様の切り分け・単価の単位・見出しの読み替えなどだけをLLMに回してデータベースに入れます。数百シート規模の実データで完走し、HTMLとPDFの検証報告書まで生成しました。
いまの業務の流れを画面に入力すると、どこが人手で詰まっているか、どの工程を自動化できるかをその場で診断します。現状のフローと改善後のフローが並んで出るので、社内で話す材料になります。商談の冒頭でその場で触っていただくための道具です。
業種・人数・1日の処理件数・扱う書類・1件あたりの時間などをフォームで受け取り、LLMに決まった形式で現状フロー・改善後フロー・施策・効果試算を返させて画面に描きます。効果の金額はAIが前提を置いて出した推定値で、実測値ではありません。
外部に委託している定型業務を、AIと仕組みで内側に戻す検討をします。紙の申込書を1回読み取るだけで、データ化・不備チェック・基幹システムへの登録判定までつなげる形を設計します。問い合わせ対応の部分は、実際に触れるデモを用意しています。
書類はAI-OCRで読み取ってルールで不備を判定し、電話・郵送・メール・チャットの受付を共通の処理へ集約して基幹システムに反映する構成です。問い合わせ対応の部分は、ナレッジ検索のデモとして実際に動かしています。
空間、動画、音声を扱う仕事です。見せ方そのものを作ります。
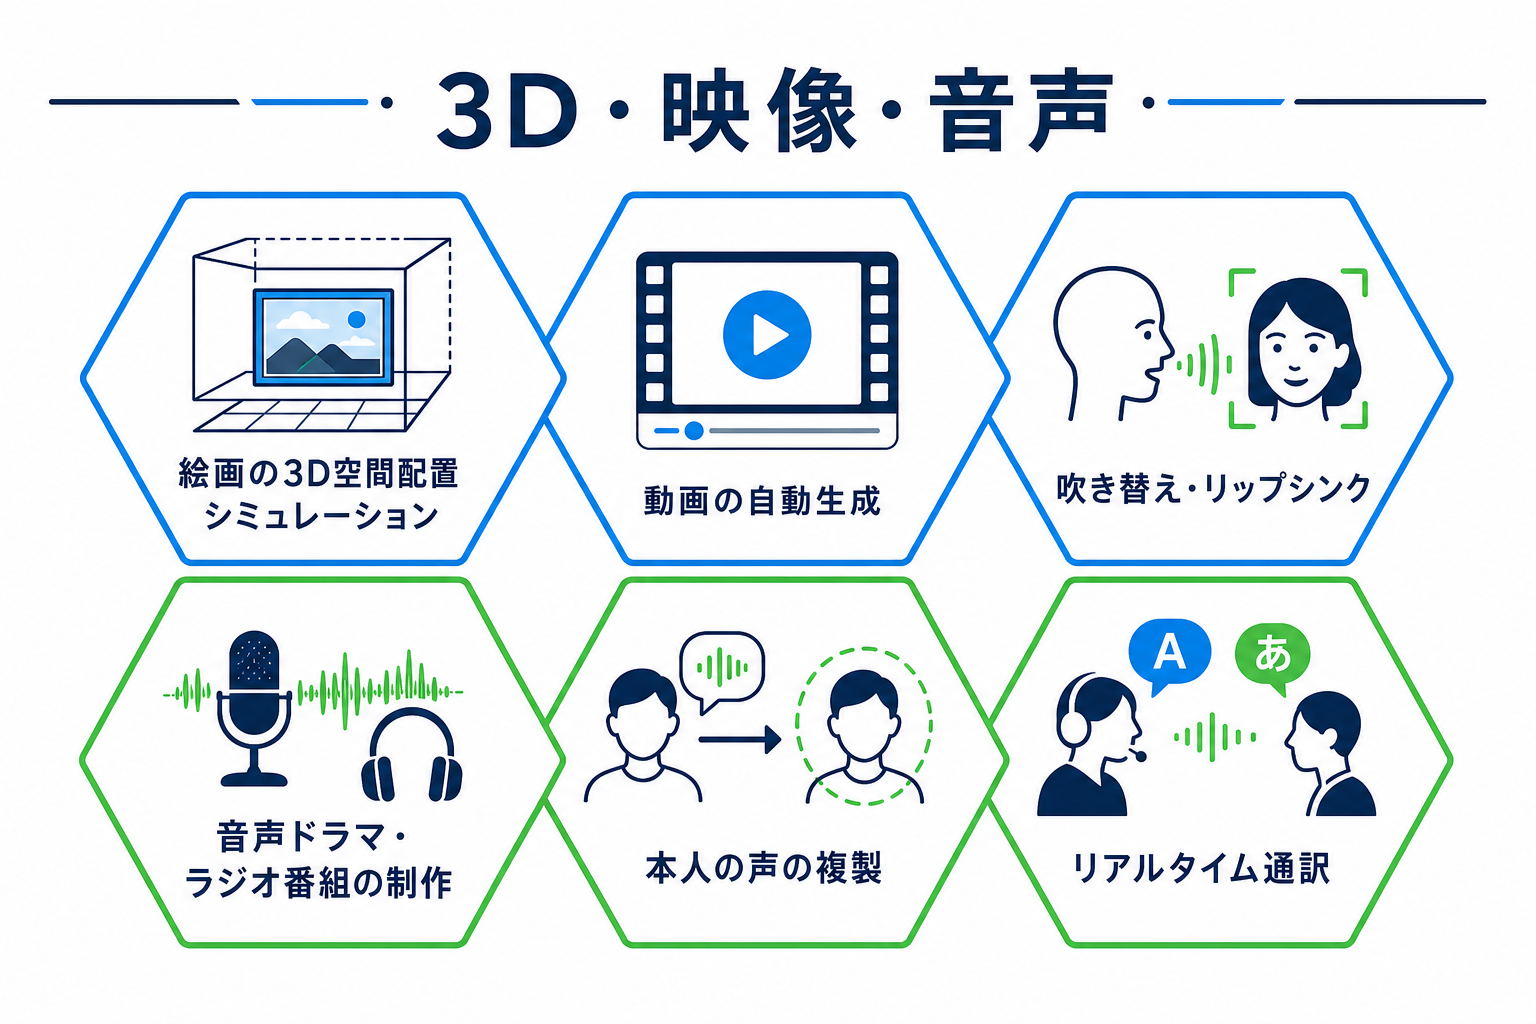
応接室や会議室の3Dモデル、またはお客様から送られた部屋の写真の壁に、実際の作品を掛けた様子を見せられます。サイズ感と雰囲気が事前に分かるので、現地に持ち込んで掛け替える手間が減ります。検索は「落ち着いた青系」のような言い方でも引けます。
ブラウザ上の3D描画(three.js)で部屋と壁を組み、写真の場合は単眼の深度推定モデルで壁を正対に起こします。2,000点を超える公開カタログの作品にLLMで検索用のタグを付け、検索語の側もLLMが解釈して辞書にも落とせるようにしています。
台本や漫画のページを渡すと、ナレーション音声・字幕・動きの付いた縦型動画が組み上がります。読み上げのタイミングに字幕が1語ずつ合うので、手で字幕を割り付ける作業がなくなります。弊社の告知動画は毎回これで作っています。
音声合成で読み上げを作り、その音声をそのまま文字起こしに回して1語ごとの時刻を取り、React ベースの動画フレームワーク(Remotion)で縦型(1080×1920)に組み立てます。背景画像の生成やページ画像のモーション付けも同じ流れに入れています。
海外アニメの日本語吹き替えを、台本づくりから声の収録、口の動きとの合わせ込みまでAIで進めます。人が最後に手を入れるための編集画面も合わせて作ります。
元の音声を文字起こしして台詞の区間を取り、尺に収まる日本語台本をLLMに書かせ、キャラクターごとの声で合成して元の映像に重ねる構成です。映像のコマごとに口の動きを解析して台詞を合わせる処理では、1話分の台詞55/56行が許容範囲に収まりました。
台本を渡すと、複数の話者が掛け合う音声ドラマやラジオ番組が1本の音源として出てきます。BGMのミックスから配信先への投稿まで含めて自動なので、収録のための時間調整が不要です。弊社のラジオ番組はこの仕組みで毎回配信しています。
テーマからLLMに台本(話者と台詞の表)を書かせ、話者ごとに別の音声合成で読み上げてBGMとミックスし、ブラウザ自動操作(Playwright)で配信プラットフォーム(stand.fm)へ公開します。記事1本をMCとナレーターの対談番組に変換する経路も用意しています。
本人の声を学習させて、原稿を本人の声で読み上げられるようにします。本人が録音に入れないときの差し替えや、同じ声で量産したいときに使えます。学習と聴き比べまで実施した試作の段階です。
50本程度の収録音声で音声合成モデルを学習し(100エポック)、そこに声質変換(RVC)を重ねて本人らしさを上げる構成を試しました。聴き比べの結果、実務では日本語の自然さが優る商用の音声合成と使い分けています。
会話をその場で別の言語に通訳し、相手側に字幕と音声で届けます。話し終わってから通訳が届くまでが1秒前後なので、会話のテンポが保てます。スマートフォンのブラウザから使える試作があります。
ブラウザのマイク音声をサーバーがリアルタイム音声AIへ中継し、翻訳した字幕と読み上げを相手側へ返す構成です。発話の区切りの判定方式を比べた実測では、話し終わりから字幕0.89〜1.0秒・音声1.08〜1.25秒で届きました。
漫画、社内報、記事、投稿、資料。作るところまで自動化し、人は中身と判断に集中します。
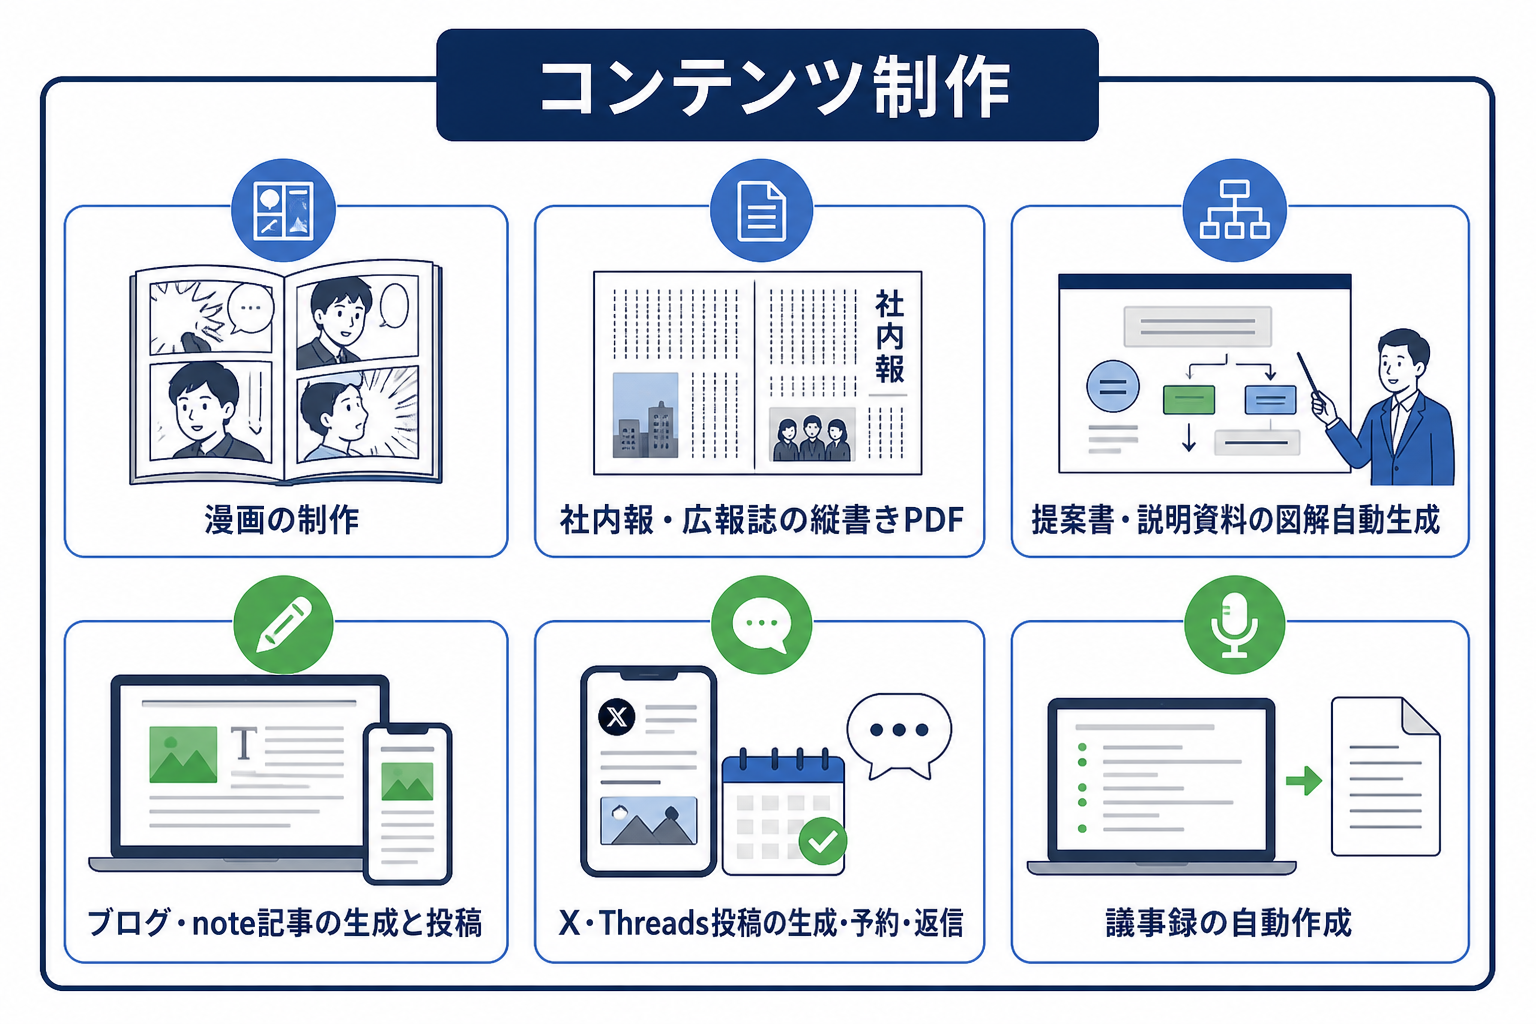
キャラクター設計、台本、コマ割り、作画、吹き出しの配置まで通して作ります。商材の説明を物語にして読ませる販促用の漫画が主な用途で、15ページの見本漫画を実際に作っています。実写写真を使ったフォトコミック形式にも対応します。
キャラクター設定と参照画像をLLMに読ませて台本とネームを作り、画像生成(gpt-image-2)でページを描き、吹き出しと効果音は画像処理ライブラリで合成してLLMがレビューします。最終のPDFはブラウザの印刷機能(Playwright)で書き出します。
縦書き・段組の社内報や広報誌を、原本のレイアウトをそのまま再現した版と、読まなくても内容が分かるインフォグラフィック版の2本立てで作ります。字が多くて読まれないという社内報の悩みに、同じ原稿で別の見せ方を用意して応えます。音声で聴ける版も作れます。
原本PDFから文字ブロックの座標を実測し、同じ位置に固定の箱を置いてCSSの縦書きで流し込み、ブラウザの印刷機能でPDFに書き出して結合します。自動の段組みに任せると原本と合わないため、座標を測って絶対配置する方式を採っています。
説明資料や提案書の原稿を渡すと、章ごとの図解が自動で入ったHTMLとPDFに仕上がります。スマートフォンからURLで開いて確認できるので、資料の体裁待ちで判断が止まりません。これまでに150本以上の資料をこの仕組みで作っています。
原稿の中に「どの場所にどんな種類の図を入れるか」をタグで書き込み、画像生成(gpt-image-2)が26種類の構図パターンから作り、HTML組版とPDF書き出しまで一括で走らせます。数値を含むグラフだけは画像生成ではなく描画ライブラリで描き、比率の誤りが出ないようにしています。
テーマを渡すと記事を書き起こし、見出し画像まで作って、ブログやnoteの下書きとして保存します。人は公開前に読んで直すだけで、書き出しと体裁づくりの時間がなくなります。
記事本文を生成して見出し画像を画像生成AIで作り、ブラウザ自動操作(Playwright)でログイン済みの状態から下書きを保存します。
投稿文の生成、日時を決めた予約投稿、他の方への返信案づくりを、1つの画面でまとめて扱えます。投稿したあとの反応も取り込むので、どのネタが伸びたかを見ながら次のネタを選べます。
投稿はブラウザ自動操作ではなく各サービスの公式API(X の API、Threads Graph API)で行い、予約配信はスケジューラ(APScheduler)が受け持ちます。投稿文の生成とスコアリングはLLMで、ネタの管理はテキストファイル(Obsidian)側に置いています。
会議や商談の録音を取り込み、文字起こしして議事録の形に整えます。発言者が「話者1」ではなく実名で入り、決まったこと・自分の宿題・相手への依頼が仕分けされて出てきます。弊社では打ち合わせのたびに自動で流れる状態にしています。
録音と文字起こしは市販のAIボイスレコーダー(Plaud)に任せ、自前で作ったのは声紋照合(ECAPA-TDNN)による実名化と、LLMによるアクションの仕分けの部分だけです。10分間隔で取り込みが走り、内容の承認はスマートフォンから行います。
スマートフォンアプリ、Macの常駐アプリ、小さな端末まで。業務システム以外も作ります。
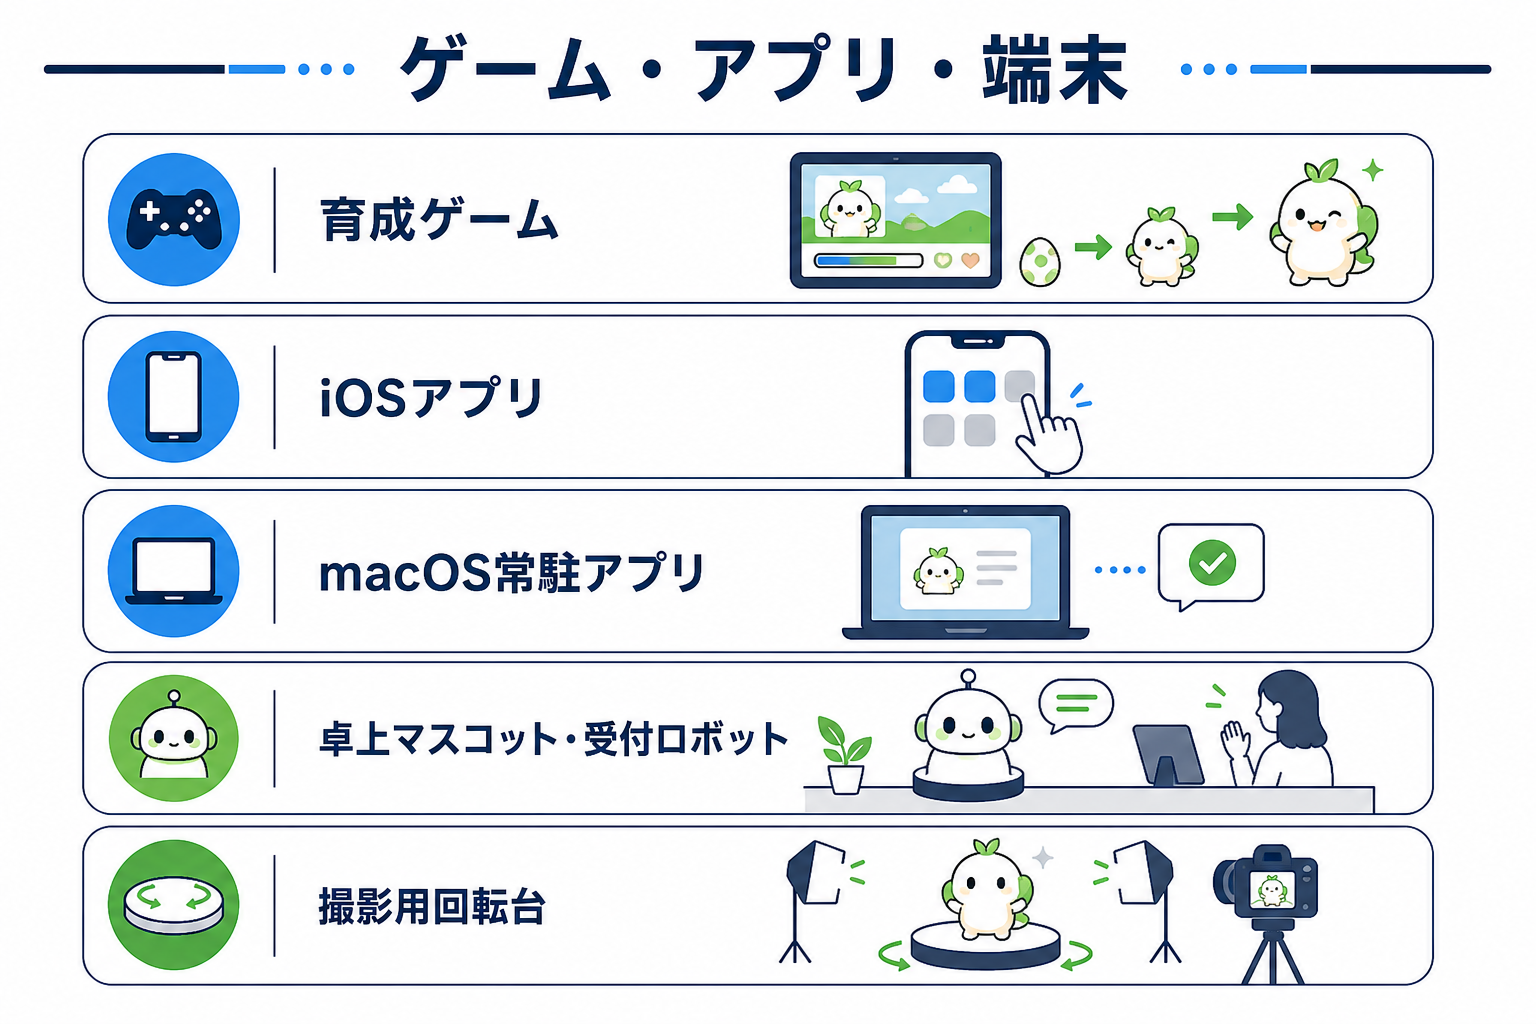
受粉で花を広げ、世界を少しずつ色づけていく育成ゲームです。遊んだ結果を押し花から造花のアクセサリーへつなげる、商品化まで含めた構想で進めています。iPhoneとWebブラウザの両方で動く試作があります。
ゲーム本体はHTML・CSS・JavaScriptで作り、同じものを Capacitor でiOSアプリとして包む構成です。セーブデータは端末内に持たせています。
スマートフォンから、AIと会話しながら開発や調査の作業を進められるアプリです。外出先からでも進捗を見て、判断を求められたらその場で返せます。署名・公証まで済ませて社外の方へ配布するところまで実施しています。
Swift と Xcode で作る素のアプリと、Web で作って Capacitor でアプリとして包むものの両方に対応します。例に挙げたツールは Mac 側に常駐するサーバーがAIのセッションを管理し、スマートフォンのブラウザから操作する作りで、実機ビルドをボタン一つで走らせる仕組みも持たせています。
Macのメニューバーに常駐して、裏で動き続けている処理の状態を一目で見せ、止める・今すぐ動かすを手元から操作できるアプリです。常駐処理が落ちていることに気づかない、という状態をなくします。
Swift と SwiftUI のメニューバー常駐アプリとして作り、各処理の生存をポーリングで確認し、起動・停止はOSの常駐管理(launchd)経由で行います。
机に置ける小型の端末が、声をかけると受付や相談相手として応答します。来客対応や社内の一次問い合わせを、画面を開かずに声だけで済ませる使い方を想定した試作です。
小型端末(M5Stack)がWi-Fiで手元のサーバーにつながり、音声認識は端末外のローカル処理、応答の生成はLLM、読み上げは音声合成という分担です。来客に触らせる用の権限を絞ったモードと、社内用のモードを分けています。
撮影対象を一定の速さで回しながら、決まった枚数を自動で撮る台をゼロから作っています。台座の3Dプリント、モーター制御、スマートフォンをどこに置けばよいかを画面で案内する据え付けガイドまで自作です。読み取りの精度は撮り方で決まるため、「撮る側の条件」を揃えられることを狙っています。
小型マイコン(Raspberry Pi Pico)がステッピングモーターで回転と前後スライドを動かし、Mac側のサーバーがUSB経由でコマンドを送って撮影と連動させます。台座は OpenSCAD で設計して3Dプリントし、据え付けはスマートフォンの傾きセンサーと目印の写り幅から、角度・距離・位置の可否を判定します。
何を作るか、どこに置くか、何を作らないかを決める仕事です。作らない方がよい場合はそう言います。
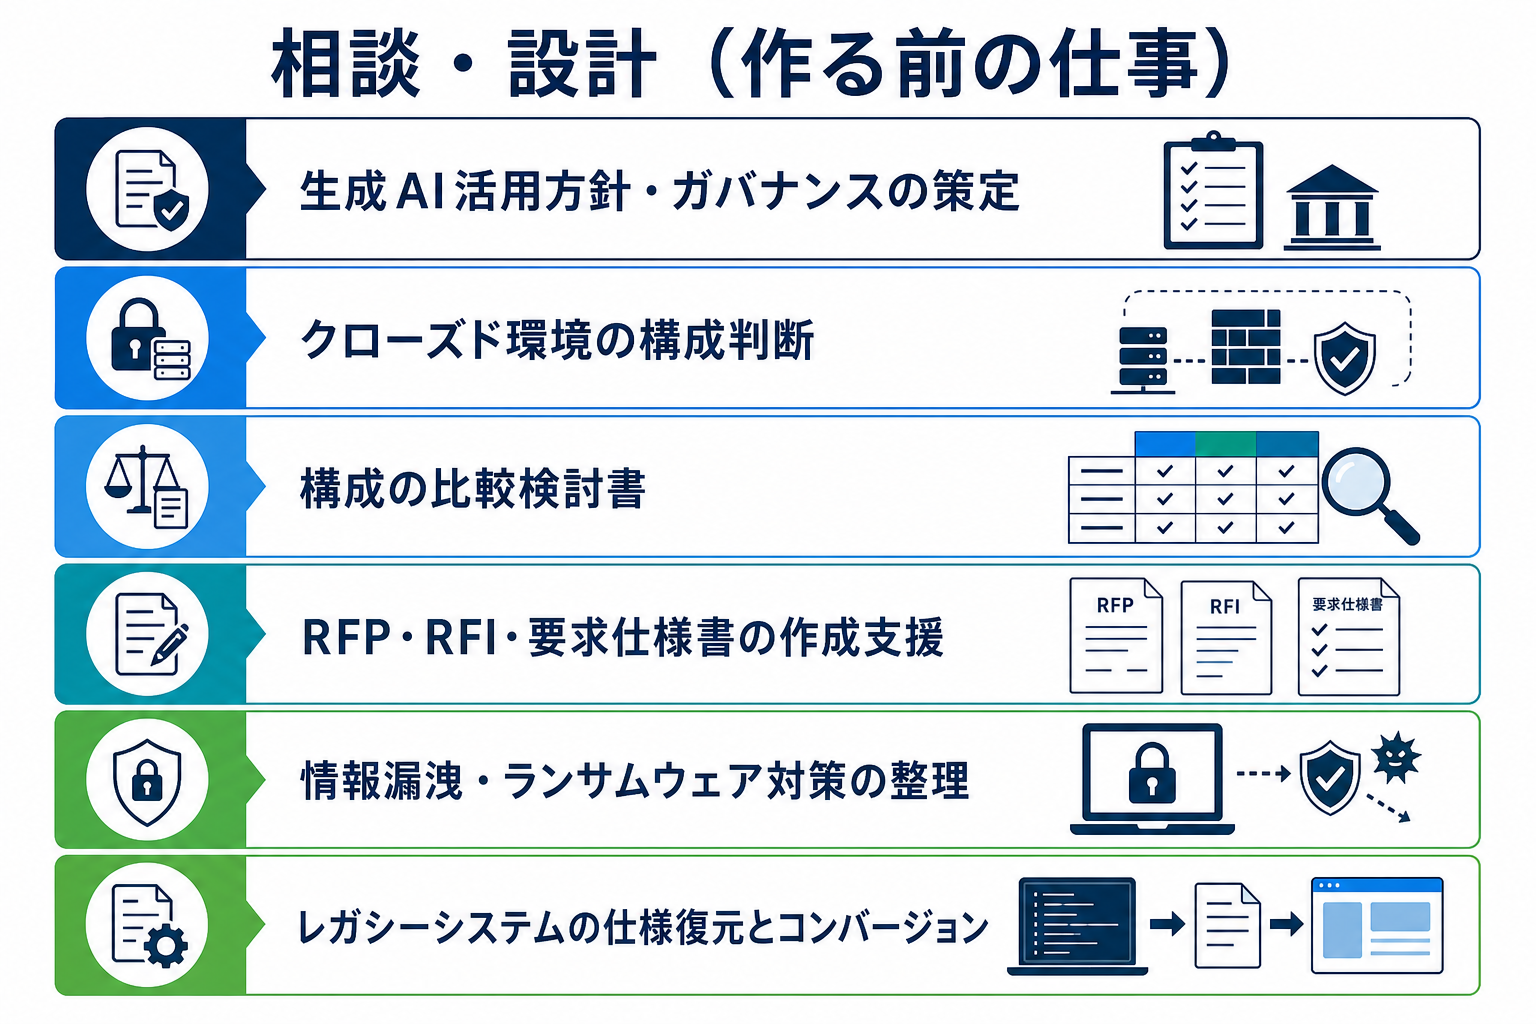
生成AIを「何に使ってよく、何に使ってはいけないか」を、組織として文書で決めるところを支援します。禁止事項を並べるだけでは現場が守れないので、入口を1つに絞って、そこを通れば安全という形に設計します。提案・設計の段階で複数のお客様にお出ししています。
情報を外へ出してよいもの・社内で共有するもの・外に出さないものの三層に分け、認証を1つに絞った入口を置く構成です。どの層に当たるかの振り分けはAIの推論ではなくラベルとルールで決めて、監査に耐えられる形にします。
「社内に閉じたAIが必要」という要望を、どこまで閉じる必要があるのかに分解します。契約上テナント内で完結すれば足りるのか、保存先を国内に限る必要があるのか、ネットにつながらない環境で動かさなければならないのか。ここで費用と使えるモデルの性能が大きく変わるので、作る前に決めます。
すでに社内で承認済みのクラウドサービスとの比較から「AIに渡るのは問い合わせ時の一部だけで保存されない」という線を引き、保存先の地域を選べるかどうかを「はい/いいえ」で確認して予算を立て直す判断手順を、社内の規則として固定しています。あわせて、手元で動かす場合の導入ガイドも資料化しています。
「なぜこの構成にしたのか」を、採らなかった案との比較で文書にします。安く済む選択肢をあえて採らなかった理由まで書くので、社内の決裁や後任への引き継ぎで話が止まりません。既存のクラウドで完結させる案との比較、通常のデータベースとベクトルDBの使い分け、ネットワーク構成を段階別に比べたものなどを作っています。
判断の軸を先に決めて、案ごとに費用・できること・制約を同じ表で並べ、図解つきのHTMLとPDFに仕上げます。スマートフォンから読める形でお出しして、読んだ方の指摘をその場で受け取れるようにしています。
システムを発注する側に立って、提案依頼書(RFP)や情報提供依頼書(RFI)、要求仕様書を書きます。やりたいことを要求の言葉に翻訳するので、ベンダーから返ってくる提案を同じ土俵で比べられます。既存のやり方を前提にした提案しか返ってこない、という事態を避けられます。
業務の現状と困りごとを整理したうえで、要求を番号つきで並べ、評価の観点と回答してほしい形式まで指定した文書を作ります。大手ベンダーに対して同じ水準の提案が可能かを問う形の依頼書まで作成しています。
「AIを使うと情報が漏れるのでは」という不安と、実際に被害が出ている侵入経路を切り分けて説明します。AI利用で本当に新しいのは何か、従来からある経路のうち先に手を打つべきはどこかを別の軸で整理するので、対策の優先順位が付けられます。社内説明や経営層への説明にそのまま使える資料の形でお渡しします。
AI利用のリスクと、外部からの侵入・認証情報の盗まれ方・バックアップからの復旧といった従来の論点を別の章に分け、図解つきの解説資料に仕上げます。「学習しない」という約束がサービスごとにどう違うかを並べた資料も用意しています。
仕様書が残っていない古いシステムについて、ソースコードと定義ファイルから「何をしているシステムなのか」を文書に起こし、別の言語へ移します。言語仕様書とソース一式が揃っていれば、初めて触る言語でも対応します。
既存ソースを読んで要件を番号つきの仕様書に起こし、その仕様書を正として新しい言語で作り直し、移行後は実データを旧システムと突き合わせて一致を確かめます。難しいのは言語そのものではなく、バッチの制御・データベース構造・帳票・外部システム連携と、移行後の突合の検証です。
弊社自身が毎日使っている仕組みです。お客様の案件も同じ基盤の上で回しています。
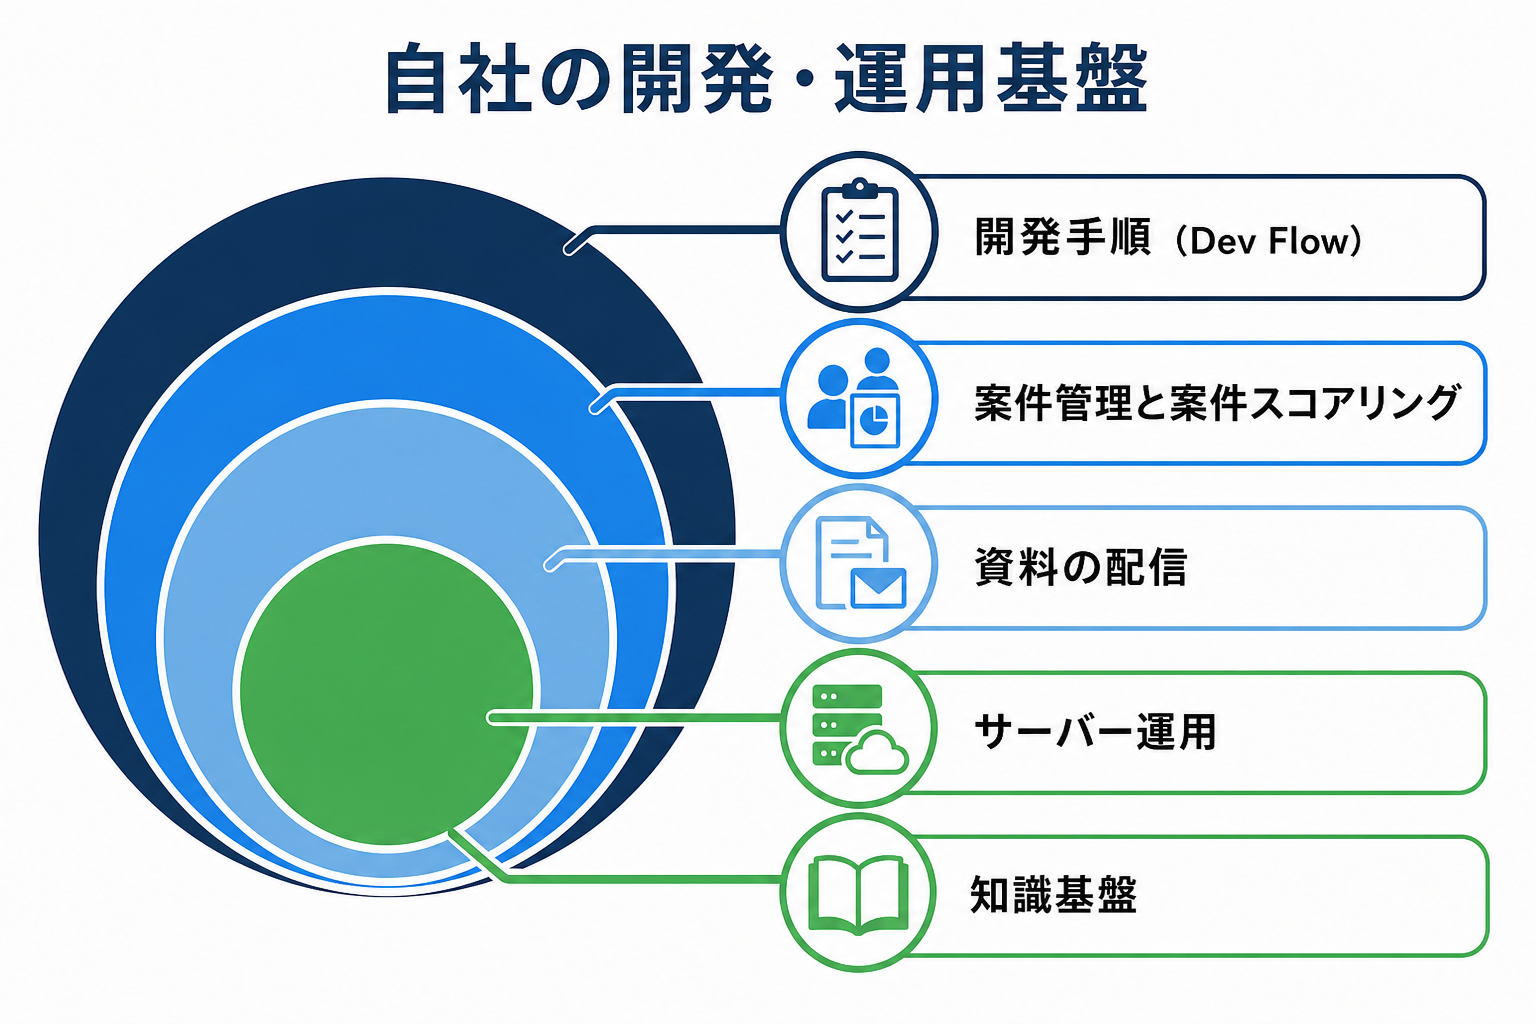
見積もりから要件定義、設計、モックアップ、実装、テスト報告までを決まった順番で進める手順です。各段階の成果物が必ずURLで出てくるので、スマートフォンから見て、止めるか進めるかを判断できます。要件に番号が振られるので、「言ったのに入っていない」が後から追えます。
段階ごとに手順書を持ち、要件定義書は機械が採点して不足を名前で出し、作業一覧はJSON、バグは発生と修正をJSONLで記録します。設計の段階では構成図・データモデル・脅威分析・監視目標まで作り、成果物はすべてHTMLで出します。
進行中の案件の進捗・フェーズ・請求状況を1画面で管理します。あわせて、新しく来た案件情報を自動で取り込んで自社に合うかを採点し、手を上げる場合のアピール文や提案書の下書きまで作ります。提案には1件ごとに費用がかかるため、上げる案件を選ぶところを機械に補助させています。
管理アプリ(Flask + SQLite)に、案件情報の自動取得(Playwright)、技術キーワードとLLM評価による採点、提案書の自動生成を組み込んでいます。採点の結果と実際の受注結果を突き合わせて見直せるよう、記録を残しています。
作った資料を、URL一つで相手に渡せる状態にしておく配信基盤です。ファイルを添付して送る代わりにリンクを送るので、版が古い資料が出回りません。社内の資料をまとめて検索もできます。
資料の置き場を定期的に走査してHTMLの成果物を索引化し、一覧・全文検索・配信をまとめて行うアプリです。現在160件程度の資料を同じ場所から配っています。
社内のMacで動かしている資産を毎晩サーバーへ同期し、Macが止まってもサーバー側で業務を続けられる状態を保っています。あわせて常駐処理の資源の使い方を監視し、重くなり始めた段階で気づける形にしています。復旧の手順も文書として用意しています。
同期は rsync と SSH で行い、障害対応中はサーバー側のフラグを見て同期を止めることで、復旧中の作業が上書きされないようにしています。監視は10秒間隔でメモリ・スワップ・負荷・ディスク書き込みを見て、連続して悪化したときだけ段階を上げて通知します。
過去にやった作業、読んだ記事、見た画面を検索できる状態にしています。「前に似たことを調べたはず」を人の記憶に頼らず辿れるので、同じ調査を二度やらずに済みます。案件の提案や設計のときに、過去の判断理由を引いて根拠にできます。
画面の記録とOCR、Webクリップの取り込み、文字起こしを入口にして、LLMで要約してノート(Obsidian)に書き出し、索引づくりと重複の統合を自動で回します。検索はキーワード(BM25)とベクトル検索(Qdrant)の両方を持たせています。